Created with Sketch.

- 技术学习 - 共 15 篇

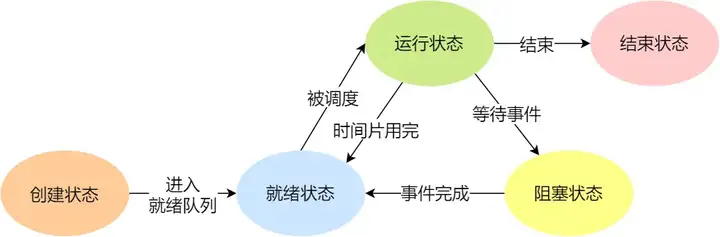
目录 概述 用户态和内核态 用户态(User Mode) : 用户态的进程拥有较低的权限,可以读取用户程序的数据。 内核态(Kernel Mode):内核态的进程拥有更高的权限,几乎可以访问计算机的任何资源(包括内存、设备、驱动程序等),能够执行更底层、更敏感的操作。当应用程序需要执行某些需要特殊权限的操作(如读写磁盘、网络通信等),就需要向操作系统发起系统调用请求,进入内核态。进入内核态的开销较高(上下文切换和权限检查),因此应尽量减少进入内核态的次数,以提高系统性能。 如果只有内核态会怎么样? 恶意程序可能会覆盖操作系统的关键代码或数据,或终止其他进程,导致系统崩溃。 所有进程都可以无限占用内存、CPU、磁盘等资源,导致资源枯竭。 用户态切换到内核态的 3 种方式 系统调用:用户态进程主动要求切换到内核态。 中断:当外围设备完成用户请求的操作后(如硬盘读写操作完成),会向 CPU 发送中断信号,CPU 立即保存当前执行上下文并转入内核态执行中断处理程序。如果中断发生时 CPU 运行的是用户态代码,则会发生用户态到内核态的切换。 异常:当 CPU 在执行用户态进程时发生异常(如缺页异常、除零错误),会触发 CPU 进入内核态,执行相应的异常处理程序,以恢复或终止进程。 系统调用 程序基本都是运行在用户态,当我们要调用操作系统提供的内核态级别的子功能(设备管理、文件管理、进程控制、内存管理等)时,就需要系统调用,由操作系统代为完成。 系统调用的过程 用户态程序通过 glibc(与系统调用一一对应的函数库)调用 syscall ,触发 Trap 进入内核态。 CPU 保存用户态上下文,并根据系统调用号查找相应的系统调用处理函数。 内核执行完系统调用后,使用 sysret 等恢复用户态上下文,CPU 切换回用户态。 中断 为了避免中断处理程序执行时间过长,Linux 将中断处理程序分为上半部和下半部: 上半部:硬中断,由硬件触发,用来快速处理中断。 下半部:软中断,由内核触发,用来异步处理上半部未完成的工作,通常都是耗时比较长的事情,特点是延迟执行。 进程和线程 进程(Process) 指正在运行的一个程序实例。举例:你打开的微信就是一个进程。 线程(Thread) 也称轻量级进程。多个线程可以在同一个进程中同时执行,并且共享进程的资源(如内存空间、文件句柄、网络连接等)。举例:你打开的微信里就有一个线程专门用来拉取别人发你的最新的消息。 进程和线程的区别 线程是进程划分成的更小的运行单位,一个进程在其执行的过程中可以产生多个线程。 进程拥有一个完整的资源平台,而线程只独享必不可少的资源,如寄存器和栈。 各进程是独立的,而各线程则不一定,因为同一进程中的线程极有可能会相互影响。 线程执行开销小,但不利于资源的管理和保护;而进程正相反。 有了进程为什么还需要线程? 线程切换和调度的成本远低于进程(共享虚拟内存无需切换页表)。 多个线程可以并发处理不同的任务,更有效地利用了多核计算机资源。而进程只能在一个时间干一件事,如果在执行过程中阻塞,就会挂起直到结果返回。 同一进程内的线程共享内存和文件,相互通信无须调用内核。 进程状态 创建状态:进程正在被创建,尚未到就绪状态。 就绪状态:进程已处于准备运行状态,即进程获得了除了处理器之外的一切所需资源,一旦得到处理器资源(处理器分配的时间片)即可运行。 运行状态:进程正在 CPU 上运行(单核 CPU 任意时刻只有一个进程在运行状态)。 阻塞状态:又称为等待状态,进程正在等待某一事件而暂停运行如等待某资源为可用或等待 IO 操作完成。即使处理器空闲,该进程也不能运行。 结束状态:进程正在从系统中消失。可能是进程正常结束或其他原因中断退出运行。 进程控制块 PCB PCB(Process Control Block)数据结构是进程存在的唯一标识,每个进程都对应着一个独立的 PCB。当进程执行时,PCB 中的信息会不断变化,相同状态进程的 PCB 通过链表链在一起(形成就绪队列、阻塞队列等),操作系统会根据这些信息来管理和调度进程: 进程描述信息,进程名称、进程标识符、用户标识符等 进程调度信息,进程状态、阻塞原因、进程优先级等。 资源需求情况,CPU 时间、内存空间、I/O 设备等。 打开的文件信息,文件描述符、文件类型、打开模式等。 处理机状态信息,通用寄存器、指令计数器、程序状态字 PSW、用户栈指针。 进程间通信方式 管道/匿名管道(Pipes) :用于具有亲缘关系的父子进程间或者兄弟进程间的通信,只存在于内存中。 有名管道(Named Pipes) : 可以实现本机上任意两个进程间通信。有名管道遵循 FIFO,以磁盘文件的方式存在。 消息队列(Message Queuing) :无需等待消息被读出再返回;并且每个消息体都是固定大小的存储块,发送方和接收方能够约定好其数据类型;此外
目录 爬楼梯 背包问题 热门题🔥 爬楼梯 一维爬楼梯 先从简单但最经典的开始! 70. 爬楼梯:假设你正在爬一个 n 阶的楼梯,每次可以爬 1 或 2 个台阶。有多少种不同的方法可以爬到楼顶呢? 思路:定义 dp 表示爬 i+1 阶楼梯的方法总数。 状态转移方程:dp = dp + dp 。 初始值:dp[0] = 1,dp[1] = 2 。 空间优化:观察到一旦算出 dp ,dp[i−2] 及其左边的状态就永远不会用到了。 二维爬楼梯 62. 不同路径:从 m x n 网格的左上角开始,每次只能向下或者向右移动 1 步,到达网格的右下角共有多少条不同的路径? 思路:定义 dpi 表示到达网格 (i, j) 的方法总数。 状态转移方程:dpi = dpi-1 + dpi 。 初始值:i = 0 或 j = 0 时,dpi = 0 。 类似问题: 118. 杨辉三角 119. 杨辉三角 II 背包问题 问题描述:给定容量 target,以及一组物品的大小数组 weights,如何选取物品使得正好填满容量? 完全背包问题 每种物品可以无限次使用。 0/1背包问题 每种物品最多只能被选取一次。 例题: 416. 分隔等和子集(0/1背包问题) 热门题🔥 32. 最长有效括号 问题描述:给定只包含 '(' 和 ')' 的字符串,找出最长有效且连续括号子串的长度。 - 示例 1:输入:"(()" 输出:2 - 示例 2:输入:")()())" 输出:4 - 示例 3:输入:"()(())" 输出:6 思路:定义 dp 表示以下标 i 字符结尾的最长有效括号长度。以 '(' 结尾的子串对应的 dp 值必定为 0 ,因此我们只需讨论以 ')' 结尾的情况: s = ')' 且 s[i−1] = '(':此时字符串形如 "……()" 。因此 i > 1 时,有 dp = dp[i−2] + 2 ;如果 i = 1 ,则 dp 直接等于 2 。 s = ')' 且 s[i−1] = ')':此时字符串形如 "……))" 。因此去找 i 前面对应字符 prev 是否为 '(' ,其下标为 i 减去前一个字符已匹配的长度(i - dp - 1);如果匹配,则 dp 在 dp 的基础上加 2 ;如果 prev 前还有字符,则再加上 prev 前已匹配的长度 dp - 2] 。 300. 最长递增子序列 问题描述:找出整数数组 nums 中最长严格递增子序列(可不连续但按序)的长度。 - 示例 1:输入:[0,1,0,3,2,3] 输出:4(即 [0,1,2,3]) - 示例 2:输入:[7,7,7,7,7,7,7] 输出:1 (即 [7]) 思路:定义 dp 表示以下标 i 的整数结尾的子序列最长长度。 状态转移方程:dp = max{dp} + 1,其中 0 < j < i, nums > nums ;若所有 nums 都大于 nums ,则 dp = 1。 初始值:dp[0] = 1 。

目录 这里列举几个目前我比较常用的配置(持续更新): HTTPS证书配置 301重定向 端口转发 注:修改配置后一定记得重启Nginx服务!! HTTPS证书配置 上传证书到 nginx.conf 所在目录下。(这里我建了个叫ssl的文件夹) 修改nginx.conf 配置文件: server_name中填写证书所绑定的域名; ssl_certificate 和 ssl_certificate_key 中填写证书所在的相对路径。 301重定向 server_name 中填写要重定向的域名,域名间用空格隔开。 $scheme 用于继承用户访问时使用的协议类型,也可以手动指定http或https协议。 $request_uri 继承用户的访问路径,也可以去掉这部分,将所有来自该域名的访问都重定向到特定地址。 如果需要使用 HTTPS 协议,参照上面的 *HTTP证书配置* 修改监听端口和添加ssl相关配置即可。 端口转发 当我们部署各项服务时,由于各端口仅能被一个服务使用,但我们又不希望在每次访问的时候都加上端口号, 于是我们可以通过Nginx根据用户访问的域名将其转发到不同服务的端口。 这里举一个最简单的例子:在 server_name 中填写域名,在 proxy_pass 中填写需要转发到的地址后,我们便可以通过访问 server_name 中域名以访问指定地址所部署的服务。

先挖个坑,之后再填。。 目录 B Tree & B+ Tree 红黑树(Red Black Tree) 哈希表 (Hash Table) 跳表(SkipList) 整数集合(IntSet) 压缩列表(ZipList) 快速列表(QuickList) 紧凑列表(ListPack) 布隆过滤器(BloomFilter) B Tree & B+ Tree ...... 红黑树(Red Black Tree) ...... 哈希表(Hash Table) ...... 跳表(SkipList) 思想:在单链表上增加多级索引(空间换时间)。地铁快慢线?(bushi) 时间复杂度:O(log N);空间复杂度:O(n) ;插入/删除时间复杂度:O(log N) 。 下图中,如果要找到值为 17 的结点,单链表需要遍历10个结点,而跳表仅需遍历7个。 如下图所示,假如我们要查找的数据是 x ,在第 k 级索引中,我们遍历到 y 结点之后,发现 y < x < z ,所以我们通过 y 的down指针下降到第 k-1 级索引。在第 k-1 级索引中,y 和 z 之间只有3个结点,故每一级索引最多只需要遍历3个结点。 索引动态更新:当我们不断地往跳表中插入数据时,我们如果不更新索引,就有可能出现某两个索引节点间数据非常多的情况,极端情况下,跳表还会退化成单链表,如: 因此,当我们往跳表中插入数据的时候,我们可以通过一个随机函数生成值 K ,来决定这个结点添加到第一级到第 K 级的索引中: Redis中Zset的实现:由 zskiplist(保存跳跃表节点的相关信息)和 zskiplistNode(表示跳跃节点)定义。 zskiplist 包含以下属性: header:指向跳跃表的表头节点。 tail:指向跳跃表的表尾节点。 level:层数最大的节点层数(不含表头节点)。 length:目前包含节点的数量(不含表头节点)。 zskiplistNode 包含以下属性: level:L1 代表第一层,L2 代表第二层,以此类推。每个层都带有两个属性:前进指针和跨度。前进指针用于访问位于表尾方向的其它节点,而跨度则记录了前进指针所指向节点和当前节点的距离。 BW:后退(backward)指针,指向当前节点的前一个节点,在程序从表尾向表头遍历时使用。 score:各节点保存的分值,节点默认按分值升序排列。 obj:节点所保存的成员对象(实际开发中,索引节点无需存储完整对象)。 Redis为什么用跳表而不用平衡树? 内存占用:平衡树每个节点包含 2 个指针(指向左右子树),而跳表每个节点平均包含 1/(1-p) 个指针,Redis中取 p=1/4 ,即 1.33 个指针。 范围查找:平衡树中找到指定范围的小值之后,还需要以中序遍历的顺序继续寻找其它不超过大值的节点;跳表只需要在找到小值之后,进行若干步的遍历即可。 实现简单:平衡树的插入和删除可能会引发子树的调整;跳表仅需修改相邻节点指针。 内存友好:B+ 树的设计目标是优化磁盘 I/O,通过减少树的高度来降低磁盘寻道次数,而 Redis 是内存数据库。 参考资料:1,2,3 整数集合(IntSet) 整数集合本质上也是一块连续内存空间。当新加入的元素类型( int32_t )比整数集合现有所有元素的类型( int16_t )都要长时,整数集合需要先自动升级,按新元素的类型扩展 contents 数组的空间大小,然后才能将新元素加入到整数集合里,升级的过程中也要维持整数集合的有序性。 压缩列表(ZipList) 压缩列表是由连续内存块组成的顺序型数据结构,类似于数组。不仅可以利用CPU缓存,而且会针对不同长度的数据,进行相应编码,能够有效节省内存开销。 不能保存过多的元素,否则查询效率就会降低(从头遍历到尾)。 元素数量增加或长度发生变化时,内存空间需要重新分配,可能引发连锁更新的问题。因此仅用于节点数量不多的场景,只要数量足够小,即使发生连锁更新也能接受。 快速列表(QuickList) 快速列表其实就是双向链表 + 压缩列表组合:QuickList 是一个链表,链表中的每个元素又是一个压缩列表。通过控制每个链表节点中的压缩列表大小或元素个数,来减少连锁更新带来的影响,从而提供了更好的访问性能。 紧凑列表(ListPack) 紧凑列表不再像压缩列表一样记录前一个节点长度的字段,只记录当前节点的长度。当向 ListPack 加入新元素时,不会影响其他节点的长度字段的变化,从而避免了连锁更新。 布隆过滤器(BloomFilter)

概述 数据结构 持久化 集群 事务 缓存 分布式锁 场景 一、概述 Redis 的优缺点 Redis 的优点?为什么快? 基于内存操作:绝大部分操作和数据都在内存中,相比传统磁盘文件操作减少了IO。 高效的数据结构:优化的 String、Hash、List、Set、Zset 等数据结构。 采用单线程:省去上下文切换和CPU的开销,同时不存在资源竞争,避免死锁。 单线程:命令执行使用单线程进行处理。因为 Redis 的瓶颈不是 CPU,最有可能是机器内存或网络带宽,并且单线程易于实现。 多线程:Redis 6.0 以后,多线程用于处理网络数据的读写和协议解析,充分利用 CPU 资源,减少网络 I/O 阻塞带来的性能损耗。 删除大 key 时使用 unlink 异步删除而不是 del,否则会造成单线程阻塞。 I/O多路复用:一个服务端进程(复用)同时处理多个套接字描述符(多路),根据 Socket 上的事件来选择对应的事件处理器进行处理。 Redis 的缺点?为什么不做主数据库只做缓存? 内存限制:数据库容量受到物理内存的限制,不能用作海量数据的高性能读写。 数据持久化:尽管采用了数据持久化机制,如果服务器崩溃或断电,内存中数据仍可能丢失。 数据安全:不具备像主数据库一样复杂的认证和审计机制。 结构化查询:作为键值(Key-Value)数据库,对结构化查询支持较差。 事务处理:对复杂的事务无能为力,比如跨多个键的事务处理。 在线扩容:在集群容量达到上限时在线扩容会变得很复杂。 为什么用 Redis 而不用 Map 做缓存? Map 实现的是本地缓存,其生命周期随着 JVM 的销毁而结束,且在多实例的情况下,每个实例都需要各自保存一份缓存,缓存不具有一致性;而 Redis 的分布式缓存具有一致性,各实例共用一份缓存数据。 Redis 可单独部署,在多个项目间共享。 Redis 的缓存可以持久化,Map 是内存对象,程序一重启数据就没了。 Redis 可以用几十G内存来做缓存,Map 不行。 Redis 可以处理每秒百万级的并发。 Redis 缓存有过期机制和丰富的 API。 Redis 应用场景 缓存热点数据:缓解数据库的压力。用户在访问业务数据时,先到 Redis 中拿;如果不存在,再到 MySQL 中拿,接着把访问过的数据写入 Redis。 社交网络:Redis 的哈希、集合等数据结构能很方便的的实现排行榜、共同好友等功能;利用 Redis 原子性的自增操作,可以实现计数器的功能,比如统计用户点赞数等;也可作限速器,如秒杀场景中防止用户快速点击带来不必要的压力。 消息队列:Redis 提供了发布/订阅模式及阻塞队列功能,能够实现简单的消息队列,实现异步操作。 分布式锁:分布式场景下,无法使用单机环境下的锁对多个节点上的进程同步。可以使用 Redis 自带的 SETNX(SET if Not eXists)命令或 RedLock 分布式锁实现。 数据过期策略 Redis 采用了惰性删除和定期删除相结合的过期策略: 惰性删除:不主动删除过期键,访问 key 时再检测是否过期,如果过期则删除。这种方式对 CPU 友好,但如果 key 过期后一直没有使用,则在内存中永远不会释放。 定期删除:每隔一段时间取出一些 key 进行检查并删除过期 key。分两种模式,SLOW 模式是定时任务,FAST 模式执行频率不固定,但两次间隔不低于 2ms。 数据淘汰策略 Redis 的内存不够用时,有 8 种策略来选择要删除的 key: noeviction:默认,不淘汰任何 key,内存满时拒绝写入。 volatile-ttl:优先淘汰更早过期的 key。 volatile-random:随机淘汰设置了过期时间的 key。 volatile-lru:淘汰所有设置了过期时间中最近最久未使用的 key。 volatile-lfu:淘汰设置了过期时间中最少频率使用的 key。 allkeys-random:随机淘汰任意 key。 allkeys-lru:淘汰最近最久未使用的 key。 allkeys-lfu:淘汰最少频率使用的 key。 Redis 如何做内存优化? 尽可能的将数据模型抽象到一个哈希表里面。比如一个用户对象,不要为这个用户的名称,邮箱等设置单独的 Key,而是将这个用户的所有信息存储到一张哈希表里。 二、数据结构 String 底层由 *SDS*(简单动态字符串)实现:具有 len(字符串长度 O(1) 查询)、alloc(分配给字符数组的空间长度)、flags(类型)、buf[](字符数组)属性;拼接前会自动扩容。用于: 缓存对象:JSON 等。 共享Session信息:解决了分布式系统下多服务器 Session 不一致的问题。 分布式锁:利用 SETNX 命令。 计数器:支持原子性数值操作,用于访问次数、点赞、库存等。 Hash